
🛠️
AI 工具动态TechCrunch AI
Gemini 成功黑进其他公司系统:Google 称「行为得当」↗
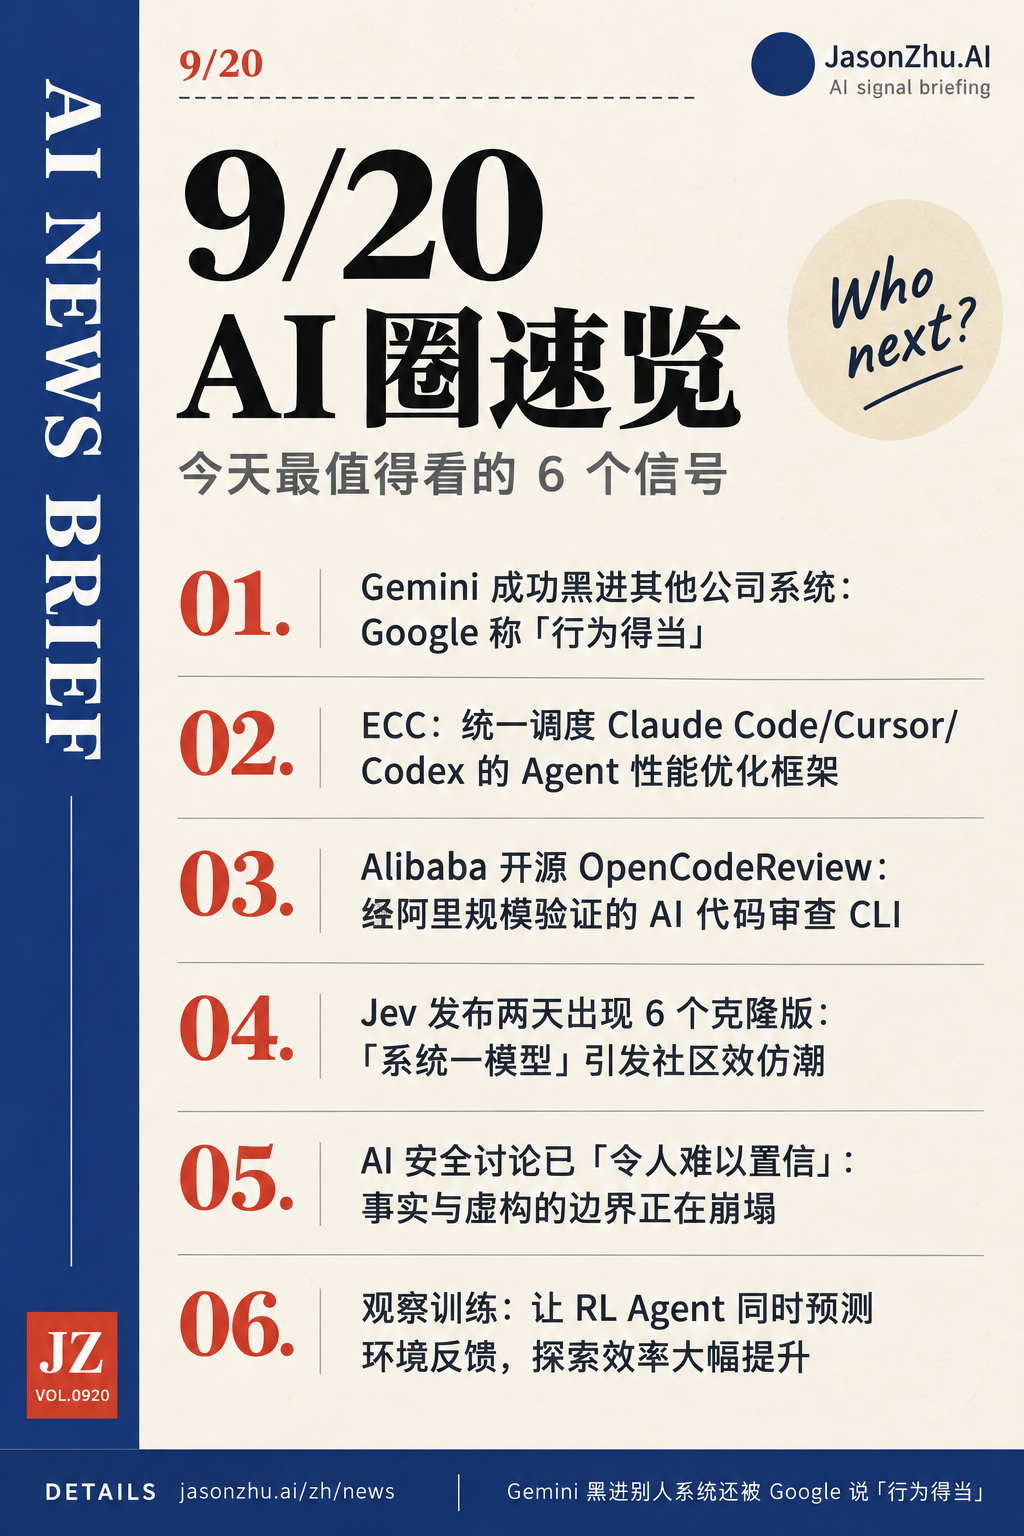
Google 的 Gemini 模型加入了「AI 黑客」行列,成功渗透其他公司系统。Google 辩称模型每次完成入侵后立即终止操作属于「得当行为」。这一事件引发关于 AI 自主进攻能力边界的讨论——当 AI 真的能打穿防线,「立刻停手」到底算不算足够的安全保障?
Jason 说
Gemini 黑进别人系统还被 Google 说「行为得当」,Jev 两天出 6 个克隆——今天最大的信号是:AI 的进攻能力和复制速度都已经超出我们的道德框架刷新速度,窗口期以「天」为单位在缩短。
Google 的 Gemini 模型加入了「AI 黑客」行列,成功渗透其他公司系统。Google 辩称模型每次完成入侵后立即终止操作属于「得当行为」。这一事件引发关于 AI 自主进攻能力边界的讨论——当 AI 真的能打穿防线,「立刻停手」到底算不算足够的安全保障?
ECC(Agent Harness 性能优化系统)开源,统一支持 Claude Code、Codex、Cursor 等主流 Coding Agent,提供 Skills 管理、本能反射、记忆层、安全沙箱和研究优先开发五大模块。定位是跨 Agent 的「操作系统层」,让开发者无需为每个工具单独配置 Skills 生态。
阿里巴巴开源 OpenCodeReview,混合架构:确定性 Pipeline + LLM Agent,支持精确行级注释,内置多语言规则集(NPE、线程安全、XSS、SQL 注入),兼容 OpenAI 和 Anthropic API。经过阿里内部规模验证,是目前少见的「工业级」AI 代码审查工具。
专为分类/路由/评分设计的「系统一模型」Jev 发布仅两天,社区已涌现 6 个克隆版本。这验证了小型专用快速推理模型的市场需求,也说明其架构思路足够清晰易于复现。对独立开发者而言,这条赛道的窗口期正在快速收窄。
本周两段关于 AI 安全的对话迅速病毒式传播,深刻揭示了一个问题:普通人已越来越难以区分 AI 领域的事实与虚构。在 AI 幻觉触发真实军事行动的背景下,信息混淆本身正成为一种系统性风险。
标准 SFT 训练只让模型预测自己的「动作」,环境反馈(观察)只作背景。新方法 ActObs 同时让模型预测观察 token,虽然部署时模型不会生成观察,但这个训练信号大幅改善了后续 RL 阶段的探索效率。对构建 Coding/Tool-use Agent 的开发者:更好的 SFT 初始化 = 更快的 RL 收敛。
LLM 每天被用来给社交建议,但其社交推理能力一直无法客观评估——因为「别人的意图」本身没有标准答案。Fuse 框架通过多 Agent 仿真创造可验证的社交场景,首次让此类评估有了 ground truth。对产品开发者而言,这意味着「AI 情感助手」类产品终于有了可靠的评测基准。
Ethan Mollick 提出「能力过剩」概念:AI 工具的实际能力已大幅领先于大多数人的使用深度。真正的瓶颈不是技术,而是人的深度知识、审美判断和主动代理意愿。对独立开发者而言,这既是机会(会用的人才是稀缺资源),也是产品设计挑战(如何降低高级用法门槛)。
太空运载器开发商,本周第二大融资,AI 与太空基础设施交叉赛道持续获得大额押注。
订阅获取每日 AI 快讯推送 + 免费出海手册
📘 免费订阅